
Famiglia GPT-6: come scegliere tra Astra, Sol e Luna senza sprecare budget
Con tre modelli GPT-6 a listino, la domanda non è più "qual è il migliore?" ma "qual è il più economico che fa bene questo lavoro?". OpenAI ha pubblicato una guida pensata per chi costruisce prodotti: qui la rileggo con l'occhio di chi deve mettere in produzione, non solo provare.
## Tre modelli, tre mestieri
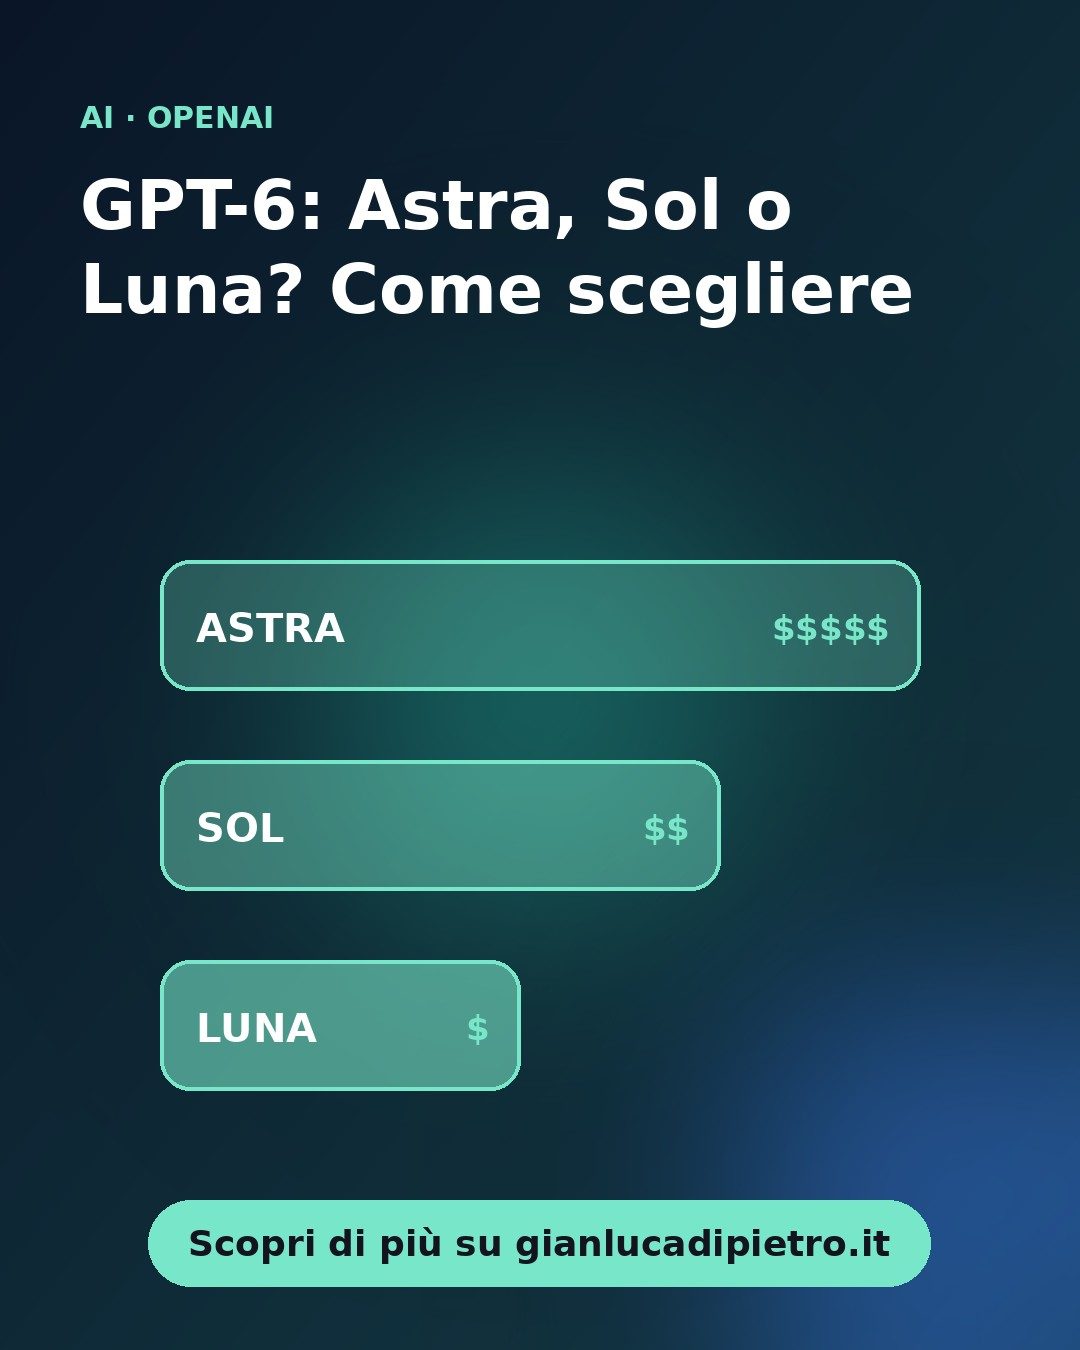
La famiglia si divide per rapporto tra intelligenza e costo, e i prezzi indicati da OpenAI per milione di token rendono la differenza molto concreta:
- **GPT-6 Astra**: il più capace, 10 dollari in input e 50 in output. Ha senso dove l'errore costa caro e il ragionamento è davvero complesso.
- **GPT-6.1 Sol**: intelligenza vicina ad Astra a circa un quinto del prezzo (2 in input, 10 in output). È il candidato naturale per coding complesso, ricerca e uso del computer.
- **GPT-6 Luna**: veloce ed economico (0,10 in input, 0,50 in output), pensato per compiti ripetuti su grandi volumi: estrazione di dati, classificazione, riassunti strutturati.
Il ragionamento pratico è semplice: parti da Sol come default, scendi a Luna per tutto ciò che è ripetitivo e ben definito, e riserva Astra ai casi in cui hai misurato che Sol non basta. Partire dal modello più potente "per sicurezza" è il modo più rapido per avere una bolletta API ingiustificabile.
## Il reasoning effort è una manopola di costo, non solo di qualità
Ogni modello permette di regolare quanto "pensare". La guida distingue quattro livelli: basso per estrazione di fatti e piccole modifiche, medio per lavoro che richiede giudizio (pianificare una funzionalità, confrontare opzioni), alto per debug difficili e revisioni accurate, e un livello massimo da provare solo quando l'alto non basta, valutando se il costo aggiuntivo è giustificato.
Nei progetti tipici l'errore è lasciare tutto al livello alto "perché funziona". Più ragionamento significa più token e più latenza: su un flusso che classifica ticket di assistenza, il livello basso su un modello piccolo è quasi sempre la scelta migliore. Il livello va deciso per singola attività, non per l'intera applicazione.
## Prompt e skill: delega chiara, autonomia dichiarata
Qui la guida è più utile di quanto sembri. Il consiglio non è "scrivi prompt più lunghi", ma dare un incarico completo: risultato atteso, contesto, vincoli e definizione di "fatto". Per gli agenti aggiunge un punto che chi lavora in azienda riconosce subito: decidi in anticipo quali azioni il modello può compiere da solo e quali richiedono approvazione, e scrivilo (per esempio nei file di istruzioni del repository). Le descrizioni delle skill vanno tenute brevi ed esplicite.
È una questione di sicurezza prima che di qualità: un agente senza confini dichiarati prima o poi farà qualcosa che nessuno aveva previsto.
## Strumenti e costi: cache, compattazione, parallelismo
Tra le funzioni citate ci sono il prompt caching (l'input in cache costa fino al 95% in meno), la compattazione del contesto per conversazioni lunghe, la possibilità di correggere il modello a metà esecuzione via API, le chiamate asincrone agli strumenti e, in beta su Sol, la delega a sotto-agenti. Il filo comune è ridurre il contesto inutile e parallelizzare ciò che è indipendente.
Per chi sviluppa, il primo intervento a basso rischio è strutturare i prompt con la parte stabile all'inizio, così la cache lavora a tuo favore.
## Prima della produzione: misura il costo per risultato
Il criterio che consiglio di adottare, in linea con la guida, è testare su compiti rappresentativi e misurare tre cose: tasso di successo, latenza e costo per task riuscito. Un modello più economico che sbaglia molto di più può costare di più, tra rilavorazioni e supervisione. Aggiungi monitoraggio del comportamento e controlli sui dati prima di aprire il flusso agli utenti.
Un limite da tenere presente: la guida è scritta da chi vende i modelli e si rivolge alle startup. I casi citati sono utili come spunto, ma i numeri sul tuo carico di lavoro li puoi avere solo con una prova tua.
## In pratica
**1. Costruisci un piccolo set di test.** Raccogli 20-30 casi reali del tuo flusso e passali su Sol e Luna: confronta successo, tempi e costo per risultato corretto.
**2. Imposta il reasoning effort per attività.** Parti dal livello basso o medio e alzalo solo dove i test mostrano un miglioramento misurabile.
**3. Scrivi i confini dell'agente.** Elenca per iscritto cosa può fare in autonomia e cosa richiede conferma, e struttura i prompt con la parte fissa in testa per sfruttare la cache.
## Che ne pensi?
Stai già usando la famiglia GPT-6 in un progetto? Raccontami nei commenti quale modello hai scelto e perché. Se l'articolo ti è stato utile, condividilo con chi sviluppa o gestisce flussi con l'IA e iscriviti per non perdere i prossimi approfondimenti.
**Fonte:** OpenAI, "A model guide for the GPT-6 family", 2 ottobre 2026 — https://openai.com/index/practical-guide-building-gpt-6
GPT-6, OpenAI, API, reasoning effort, costi IA