
Costi Codex sotto controllo: il metodo LegalOn per scegliere il modello giusto
Quando un team di sviluppo adotta un assistente di codice, il problema dei costi arriva dopo l'entusiasmo: accesso illimitato al modello migliore, spesa che cresce, e la tentazione di mettere un tetto uguale per tutti. OpenAI ha pubblicato il caso di LegalOn, che con Codex ha scelto una strada diversa e dichiara una riduzione stimata del 65% dei costi giornalieri.
## Il punto di partenza
LegalOn ha introdotto Codex nello sviluppo e lo ha diffuso in tutta l'organizzazione. All'inizio gli sviluppatori avevano accesso illimitato al modello principale, GPT-5.5 in modalità Fast. Con la crescita dell'uso la spesa è salita, ma restrizioni generalizzate avrebbero annullato i guadagni di produttività. Il team ha quindi trattato il costo come un problema di progettazione, non di divieti.
## Le leve usate
Il primo intervento è stato dare criteri di scelta del modello. Un gruppo interno dedicato all'AI per lo sviluppo li ha definiti testando e monitorando, e i manager li hanno condivisi con i team. Ogni ingegnere sceglie comunque il modello per ogni attività, con una regola semplice: si parte da un modello leggero e si sale solo se la complessità lo richiede.
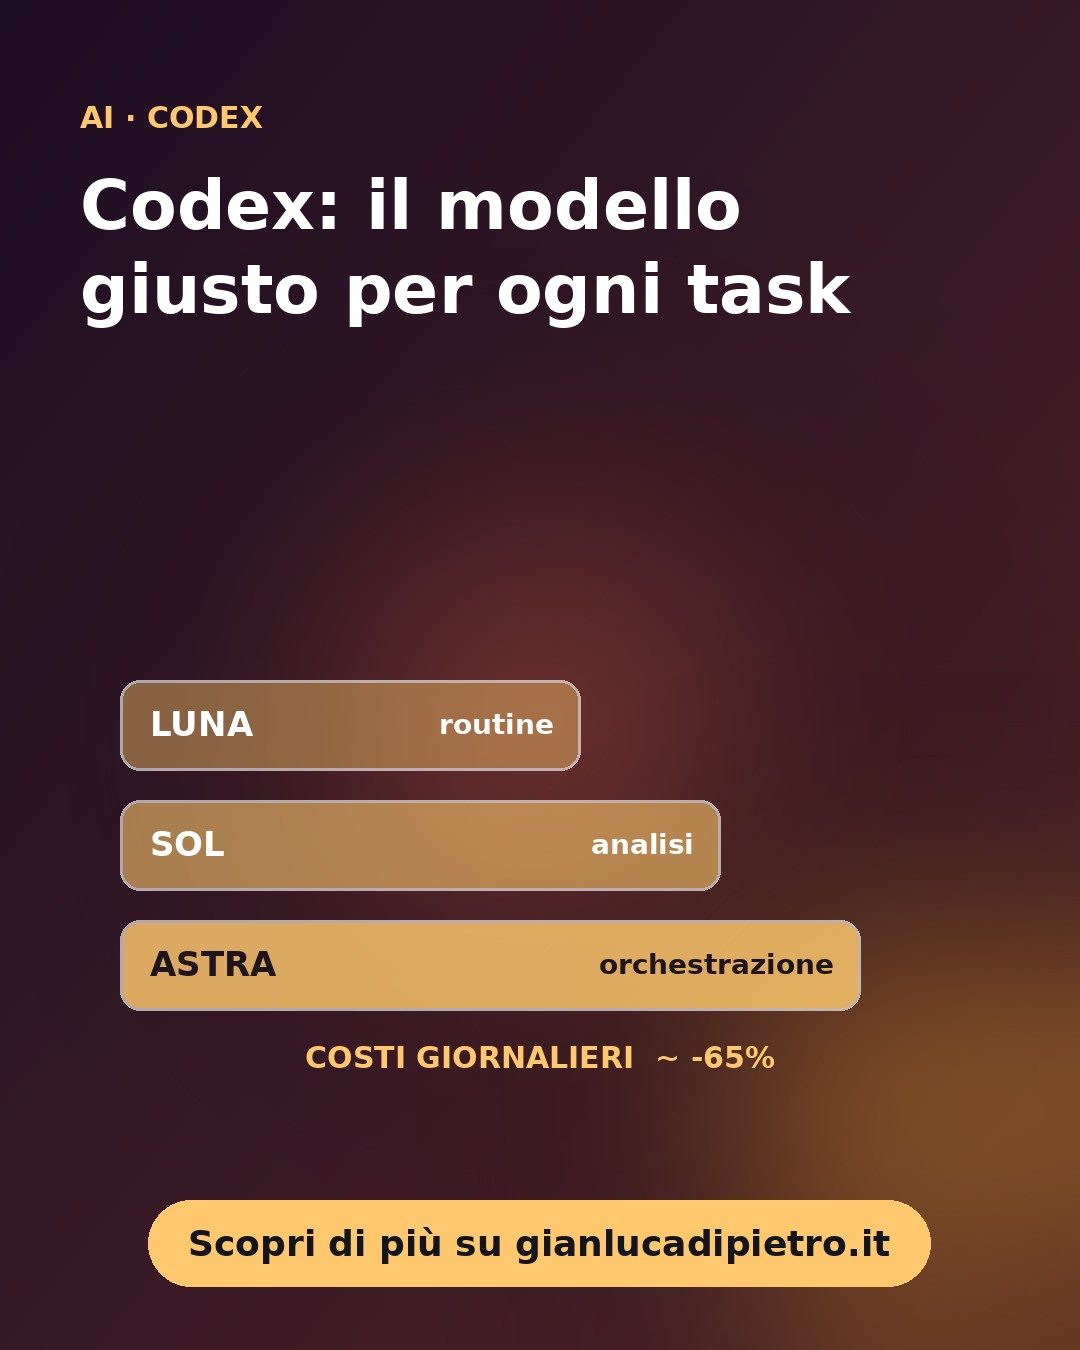
Secondo la fonte, la divisione è questa. GPT-6 Luna, il più leggero, per esecuzione quotidiana, automazioni di routine, analisi semplici e implementazione di codice, soprattutto come subagente. GPT-6.1 Sol, intermedio, per design e analisi standard, progettazione software relativamente semplice, analisi numeriche ricorrenti e documenti. GPT-6 Astra, il più capace, per analisi, design e orchestrazione complessi, e come coordinatore di più agenti.
La seconda leva è la Fast mode: disattivata di default e attivabile sulle singole richieste. Per non perdere velocità i team hanno fatto più ricorso all'esecuzione parallela delle attività. La terza leva sono i controlli amministrativi: limiti mensili per reparto e per singolo utente, monitorati e regolati nel tempo, più tetti di spesa per reparto, gruppo e individuo. Le attività consolidate hanno ricevuto l'obiettivo di migliorare l'efficienza dei costi fino a circa il 20%, mentre quelle nuove hanno avuto budget più generosi per incentivare l'uso dell'AI.
## I risultati, letti con prudenza
La fonte riporta una stima di -65% sui costi giornalieri rispetto a GPT-5.5, ottenuta combinando scelta del modello, limiti alle funzionalità e budget per attività, e un -20% sulle attività consolidate. La velocità di sviluppo, dicono, è stata mantenuta. Non sono forniti importi in dollari né misure precise della velocità, e il 65% è una stima: va letto come ordine di grandezza, non come promessa.
C'è anche un aspetto di cultura. Un manager citato nel caso osserva che regole e budget eccessivi possono minare lo slancio dell'organizzazione. I prossimi passi dichiarati vanno nella stessa direzione: un indicatore che colleghi il valore per il cliente di ogni rilascio ai costi AI, e una knowledge base con le migliori combinazioni di modelli per design, implementazione e revisione.
## Cosa si può portare a casa
Il modello è trasferibile anche a team piccoli, senza strumenti sofisticati. Il principio è lo stesso che si applica a qualunque infrastruttura: non si usa la macchina più grande per ogni job. Un modello leggero come esecutore e uno più capace come pianificatore è un'architettura sensata, soprattutto con i sub-agenti. Quello che spesso manca nelle PMI è la misurazione: senza sapere quale attività consuma cosa, ogni limite è arbitrario.
Un limite del caso: è una testimonianza pubblicata dal fornitore, su un'azienda con un team dedicato alla governance dell'AI. Per un team di due o tre persone il costo di mettere in piedi limiti e monitoraggio può non valere; la parte che vale sempre è la regola "parti dal modello leggero".
## In pratica
- **Definite una regola di default scritta**: modello leggero per routine e implementazione, modello intermedio per analisi standard, modello top solo per orchestrazione e problemi complessi.
- **Spegnete le modalità veloci di default** e attivatele solo per le richieste in cui il tempo conta davvero; parallelizzate dove possibile.
- **Tracciate il consumo per attività o reparto** per un mese prima di fissare i tetti, così i limiti si basano su dati e non su impressioni.
Se avete già una politica sui costi dei vostri assistenti di codice, raccontatela nei commenti. Condividete l'articolo con chi gestisce un team di sviluppo e iscrivetevi al blog per gli aggiornamenti.
Fonte: OpenAI, "LegalOn halves Codex costs while maintaining development speed", 8 ottobre 2026 – [https://openai.com/index/legalon-halves-codex-costs](https://openai.com/index/legalon-halves-codex-costs)
Codex, costi AI, GPT-6, sviluppo software, governance AI